数据分析计算机与 AI模式机器学习真实运行
复现一篇论文的开源代码并核对结果
帮我复现这篇论文 GitHub 仓库里的主实验:搭好环境,跑通小规模版本,把我的结果和论文表 2 对比,列出差异和可能原因。
智能体怎么做
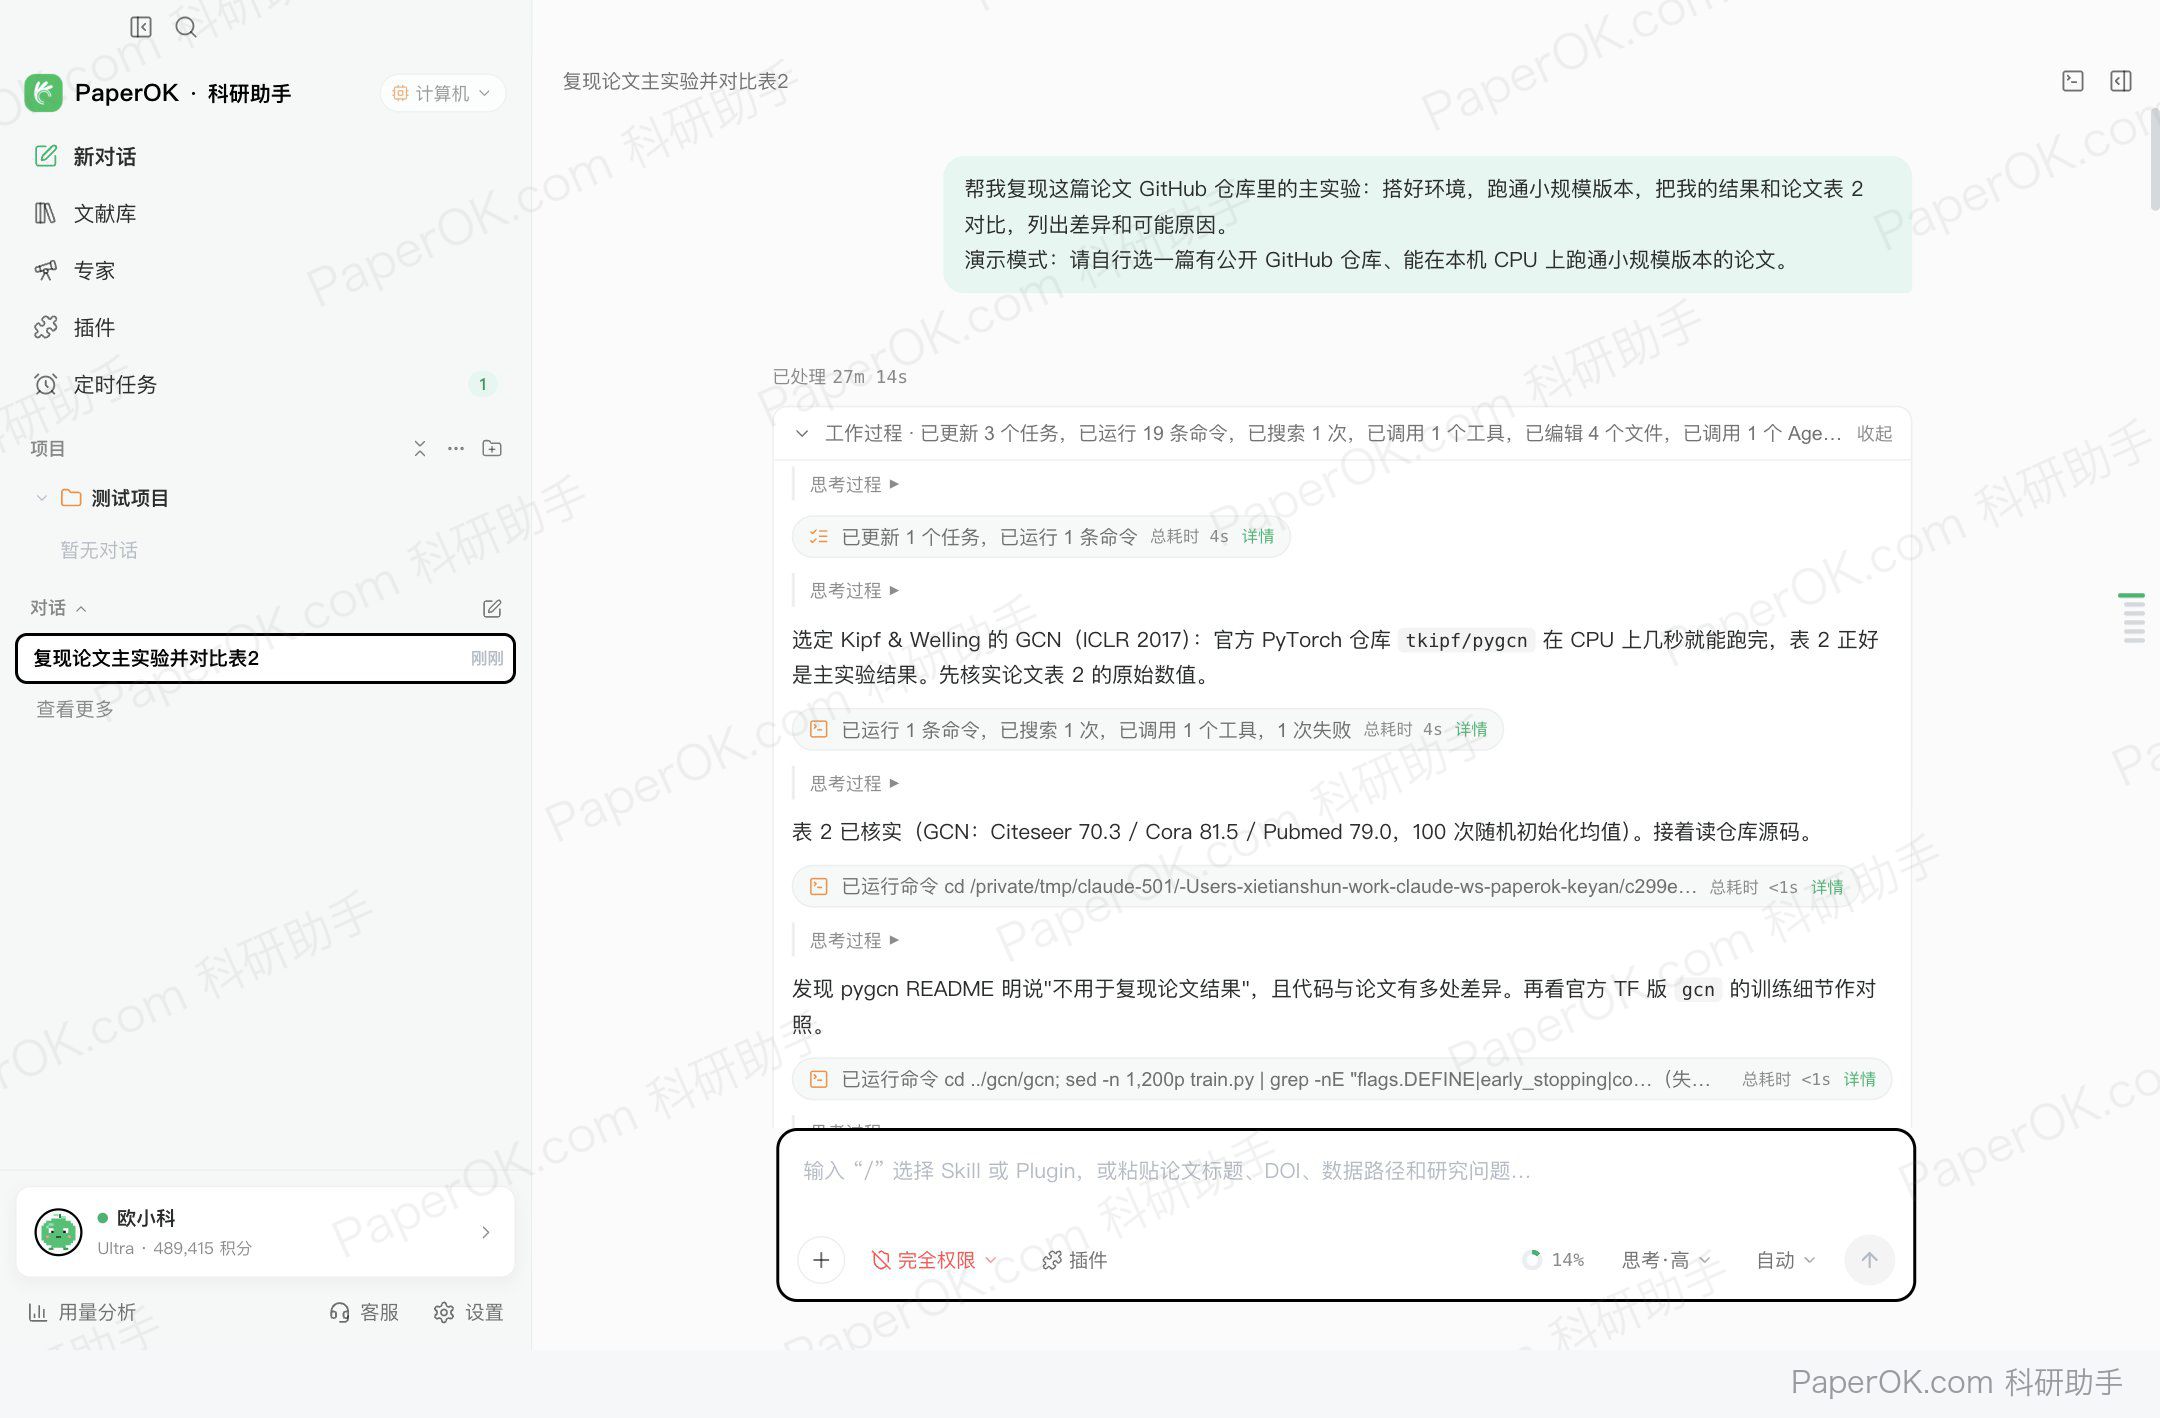
- 选论文、搭环境测试时没有指定论文,按要求选了图卷积网络 GCN(Kipf & Welling,ICLR 2017)和官方 PyTorch 仓库 pygcn;本机 Anaconda 是 x86 版、只能装旧版 torch,就改用 arm64 的 Python 3.13,仓库代码一行未改即可运行。
- 原样运行仓库100 个随机种子,Cora 82.86%,比论文高 1.4 个点;查明原因是仓库硬编码的数据划分与论文不同,还发现 --seed 固定不住结果,需要同时固定 PYTHONHASHSEED。
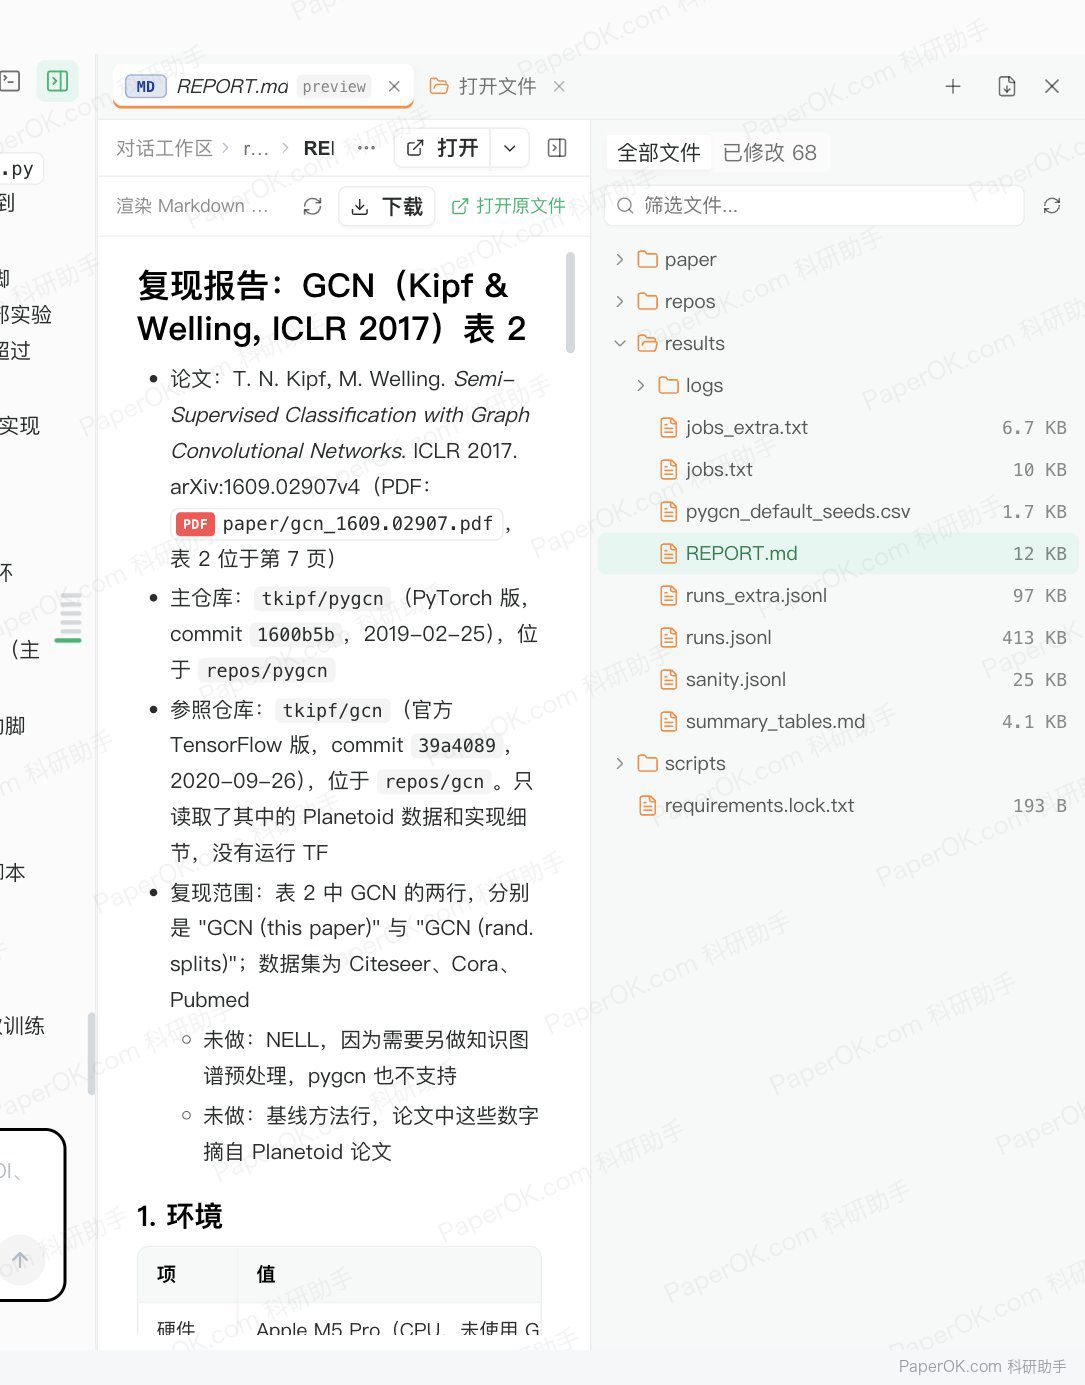
- 按论文协议复现换成论文的 Planetoid 划分、对称归一化、输入层 dropout 等设置,三个数据集各跑 100 次:Citeseer 70.79、Cora 81.52、Pubmed 79.10,论文为 70.3 / 81.5 / 79.0,差距都在 0.5 以内;随机划分一项只部分复现(Pubmed 低 1.8,标为待查)。
- 消融找原因7 项单因素消融加 2×2 分解:仓库与论文的差异主要来自行归一化(Pubmed −0.94)和缺少输入层 dropout(Cora −0.87);全部约 4,000 次训练的原始结果都保存下来。
运行截图
PaperOK科研助手中这次对话的实际界面。
运行结果
以下文件由智能体在应用中实际生成,未做修改。
表 A  论文表 2 与本次复现(Planetoid 公开划分,各 100 次)
数据集     论文 GCN   复现(论文协议)   差值    仓库原版模型 @ 同一划分
Citeseer   70.3       70.79 ± 0.76      +0.49   70.19 ± 0.72
Cora       81.5       81.52 ± 0.67      +0.02   81.05 ± 0.63
Pubmed     79.0       79.10 ± 0.29      +0.10   78.22 ± 0.32
把这个案例导入到软件里
这次运行的完整对话:打开后能看到每一步做了什么、打开生成的文件,还可以接着提问修改。
已经装好最新版 PaperOK科研助手:点「在软件中打开」,软件会自动下载并打开这个案例;也可以在软件左侧的「案例库」里找到它。点了没反应,就按下面的步骤手动导入:
- 安装 PaperOK科研助手需要 1.0.1 及以上版本,可以在下载页获取。
- 下载案例文件 paperok-case-paper-reproduce.zip(6.3 MB),下载后不用解压。
- 导入打开软件,在左侧栏「对话」标题右边点上传图标(导入对话),选择刚下载的 zip。
- 查看或继续导入完成后,这个案例会出现在对话列表最上方:展开「工作过程」看每一步,右侧文件区可以打开生成的文件,也可以直接在输入框里接着提要求。
为控制体积,超过 100 MB 的原始数据和运行环境(如 Python 虚拟环境)没有打包进去,需要重新运行时模型会自动下载或安装。对话里出现的本机路径已做匿名处理。