数据分析计算机与 AI模式自然语言处理真实运行
检索增强生成的消融实验设计与结果整理
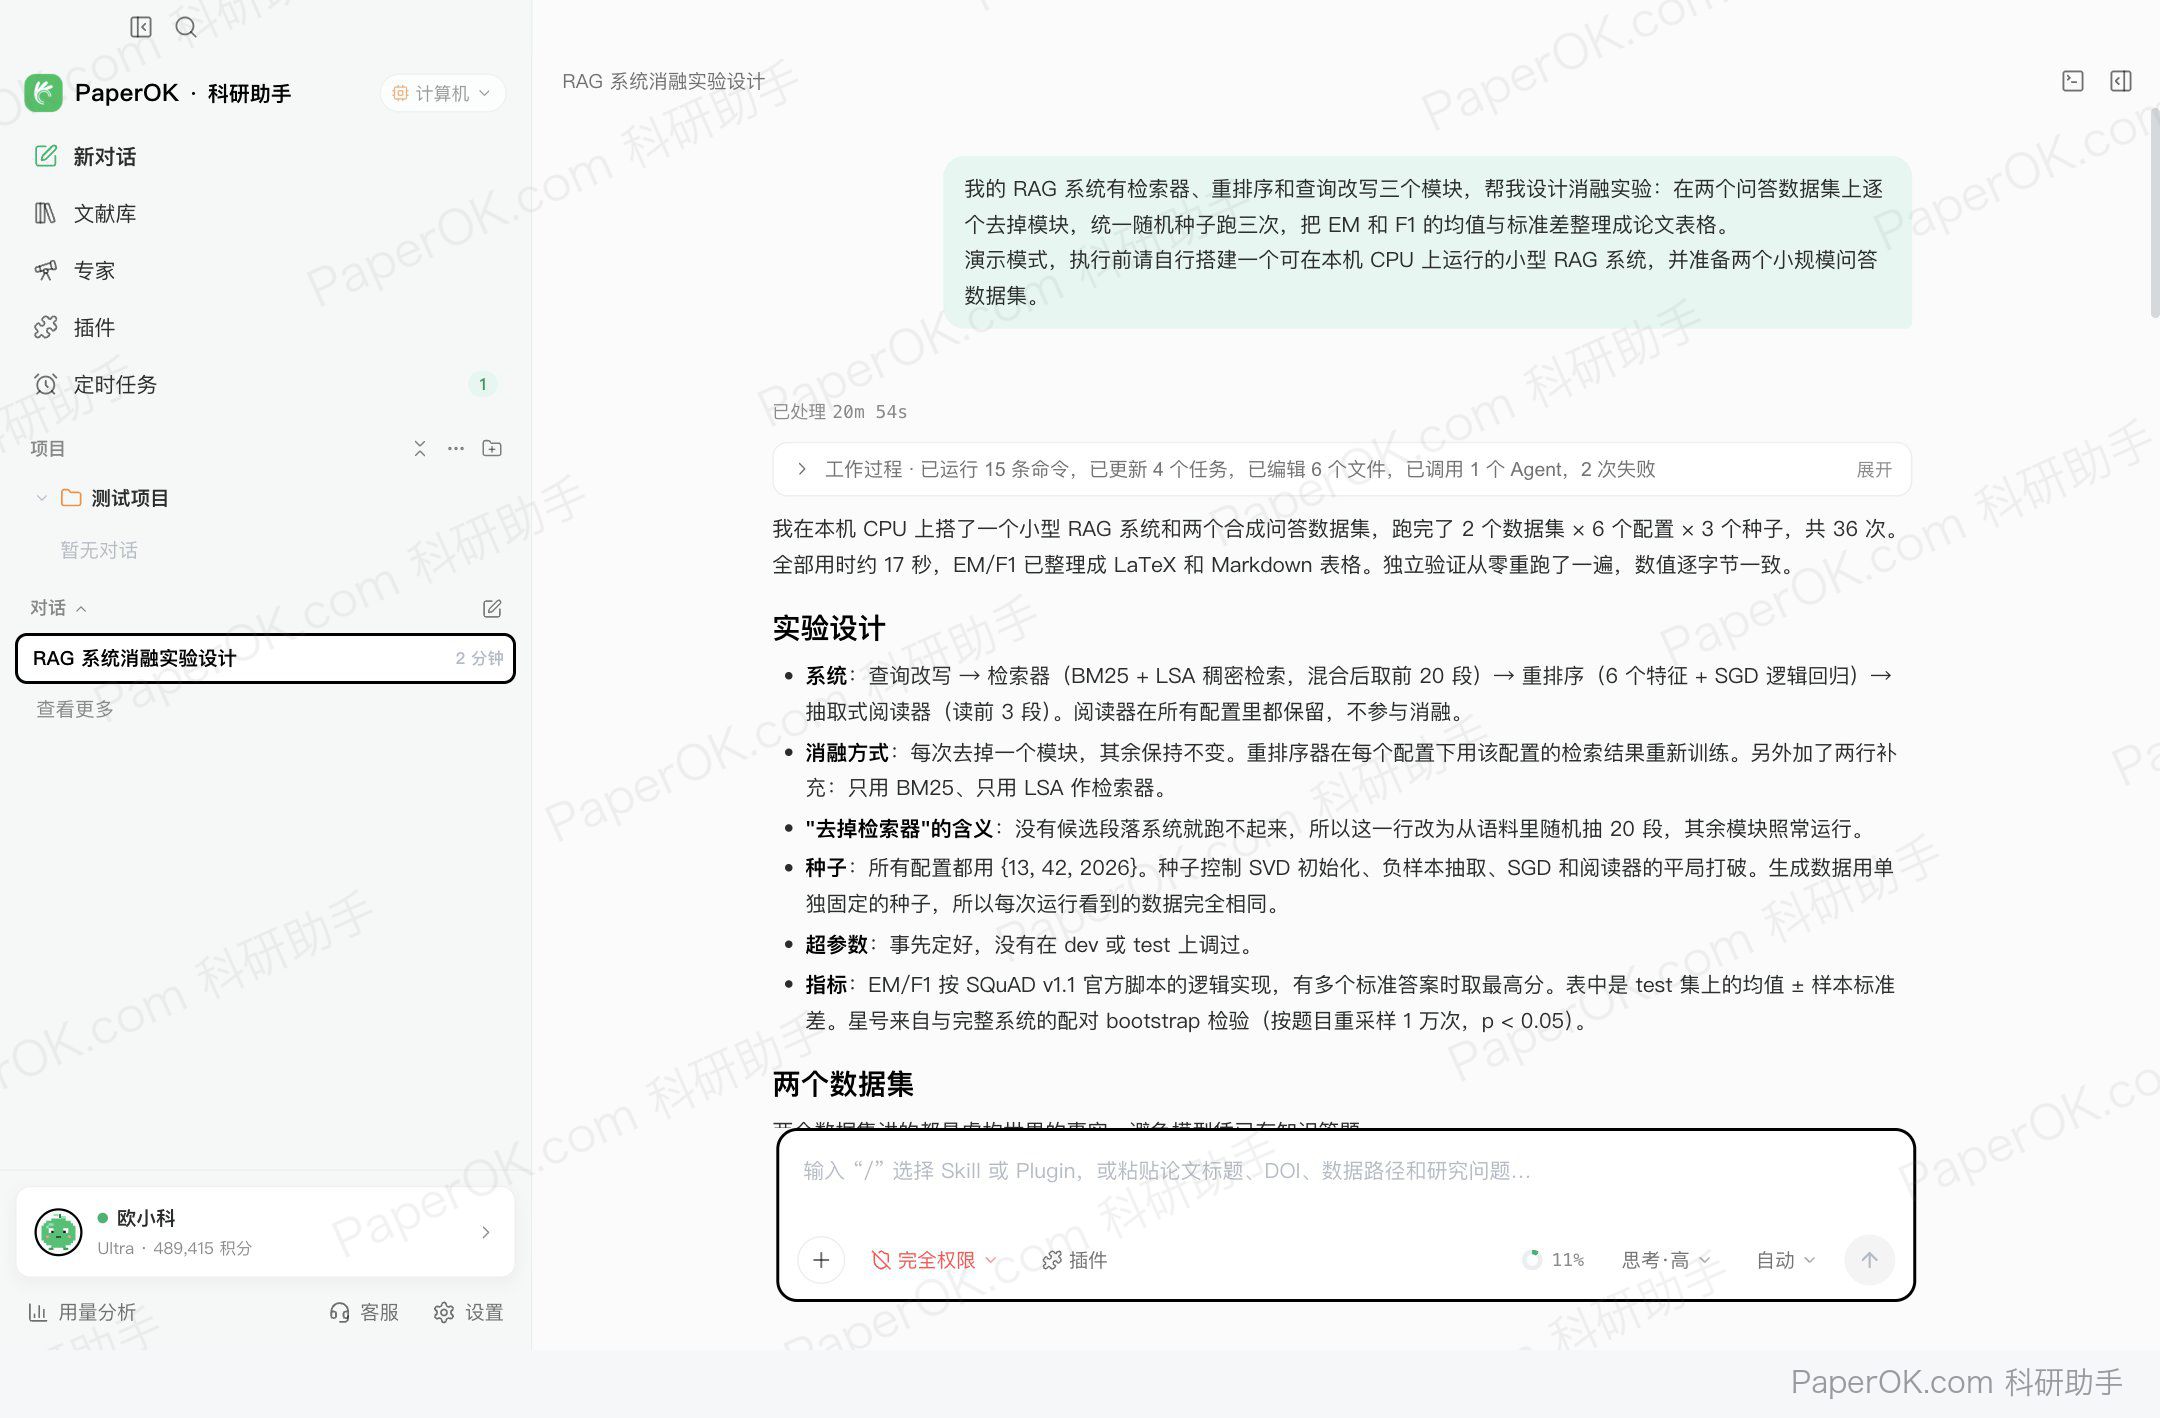
我的 RAG 系统有检索器、重排序和查询改写三个模块,帮我设计消融实验:在两个问答数据集上逐个去掉模块,统一随机种子跑三次,把 EM 和 F1 的均值与标准差整理成论文表格。
智能体怎么做
- 先搭一个能在 CPU 上跑的小系统测试时没有现成系统,按要求搭了「查询改写 → BM25+LSA 混合检索 → 特征重排序 → 抽取式阅读」的小型 RAG(不含大模型),并合成两个问答数据集(各 420/460 段文本、210 道测试题),在 README 里写明是玩具规模。
- 设计消融完整系统、分别去掉改写 / 重排序 / 检索器,再加只用 BM25、只用 LSA,共 6 个配置 × 2 个数据集 × 3 个固定种子 = 36 次运行,EM/F1 按 SQuAD 官方口径计算。
- 结果在第二个数据集上去掉查询改写,EM 从 84.3 降到 56.8,正确段落进入前 3 的比例从 96% 降到 62%;去掉重排序只降 1.9 且不显著;第一个数据集接近满分,模块差异不明显。
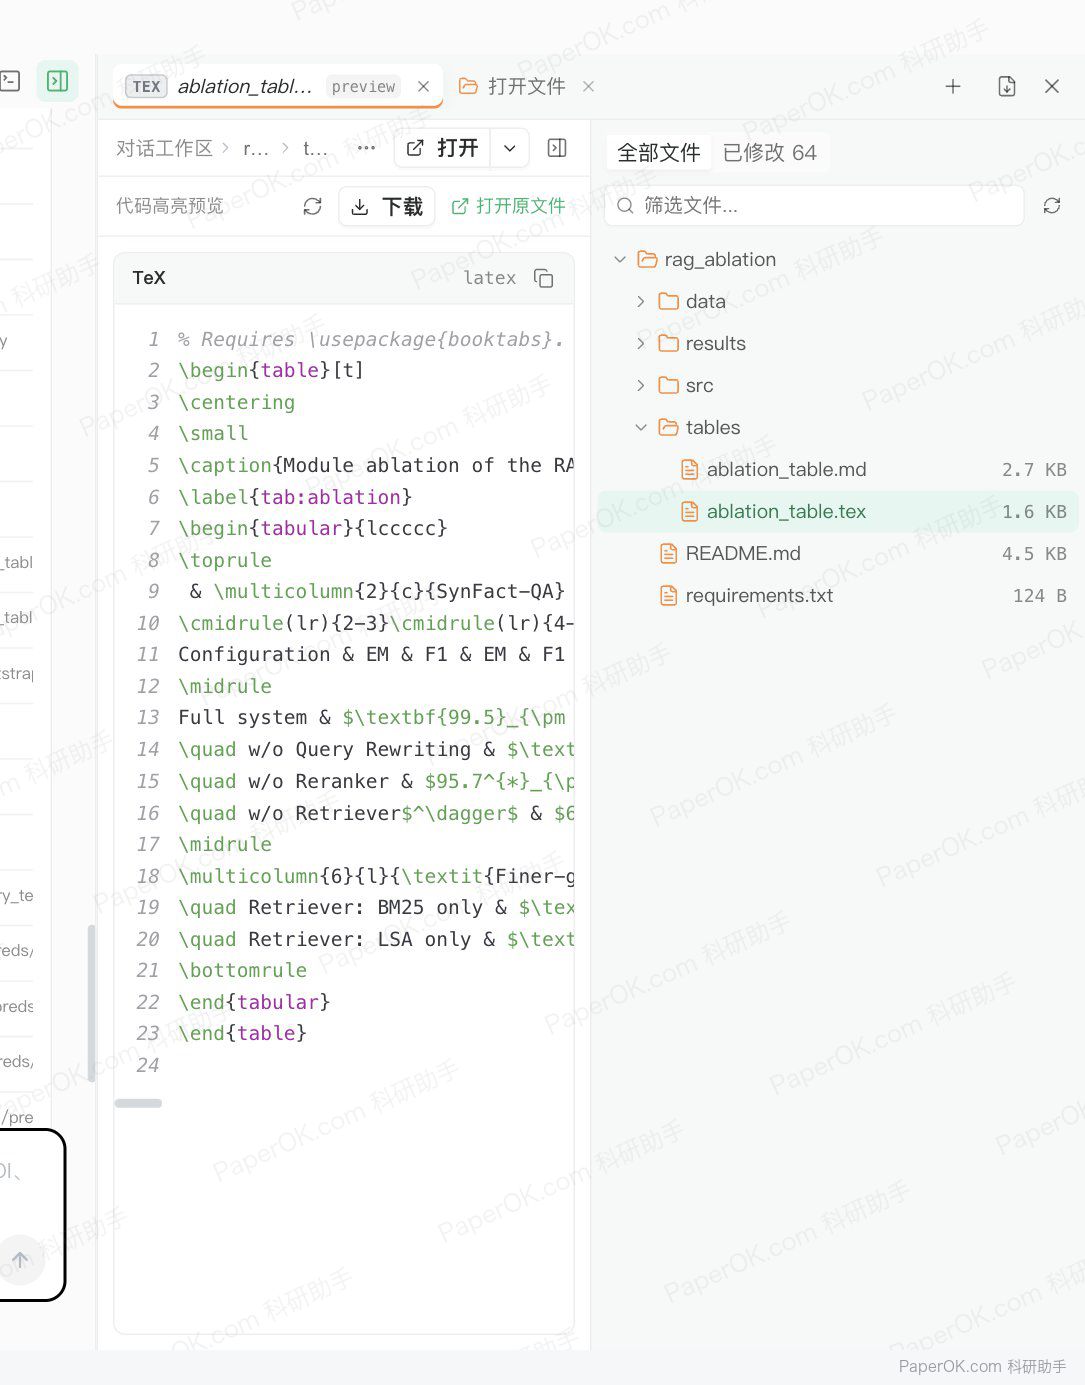
- 出表与复核输出 LaTeX(booktabs)和 Markdown 表,附逐题配对 bootstrap 检验;又派一个子代理从零重跑全部实验,结果逐字节一致。
运行截图
PaperOK科研助手中这次对话的实际界面。
运行结果
以下文件由智能体在应用中实际生成,未做修改。
| Configuration        | SynFact EM | SynFact F1 | SynPara EM  | SynPara F1  |
|----------------------|------------|------------|-------------|-------------|
| Full system          | 99.5 ± 0.0 | 99.5 ± 0.0 | 84.3 ± 0.8  | 85.1 ± 0.9  |
| w/o Query Rewriting  | 99.5 ± 0.0 | 99.5 ± 0.0 | 56.8 ± 2.8* | 58.2 ± 2.7* |
| w/o Reranker         | 95.7 ± 0.0*| 96.4 ± 0.0*| 82.4 ± 0.5  | 83.0 ± 0.5  |
| w/o Retriever†       |  6.3 ± 2.0*| 12.8 ± 2.3*|  5.1 ± 1.5* | 11.3 ± 1.9* |
| Retriever: BM25 only | 99.5 ± 0.0 | 99.5 ± 0.0 | 85.9 ± 1.8  | 86.3 ± 1.7  |
| Retriever: LSA only  | 99.5 ± 0.0 | 99.5 ± 0.0 | 83.0 ± 0.7  | 83.9 ± 0.8  |
3 个种子的均值 ± 标准差;* 配对 bootstrap p<0.05;† 第一阶段换成随机候选
把这个案例导入到软件里
这次运行的完整对话:打开后能看到每一步做了什么、打开生成的文件,还可以接着提问修改。
已经装好最新版 PaperOK科研助手:点「在软件中打开」,软件会自动下载并打开这个案例;也可以在软件左侧的「案例库」里找到它。点了没反应,就按下面的步骤手动导入:
- 安装 PaperOK科研助手需要 1.0.1 及以上版本,可以在下载页获取。
- 下载案例文件 paperok-case-rag-ablation.zip(395 KB),下载后不用解压。
- 导入打开软件,在左侧栏「对话」标题右边点上传图标(导入对话),选择刚下载的 zip。
- 查看或继续导入完成后,这个案例会出现在对话列表最上方:展开「工作过程」看每一步,右侧文件区可以打开生成的文件,也可以直接在输入框里接着提要求。
为控制体积,超过 100 MB 的原始数据和运行环境(如 Python 虚拟环境)没有打包进去,需要重新运行时模型会自动下载或安装。对话里出现的本机路径已做匿名处理。